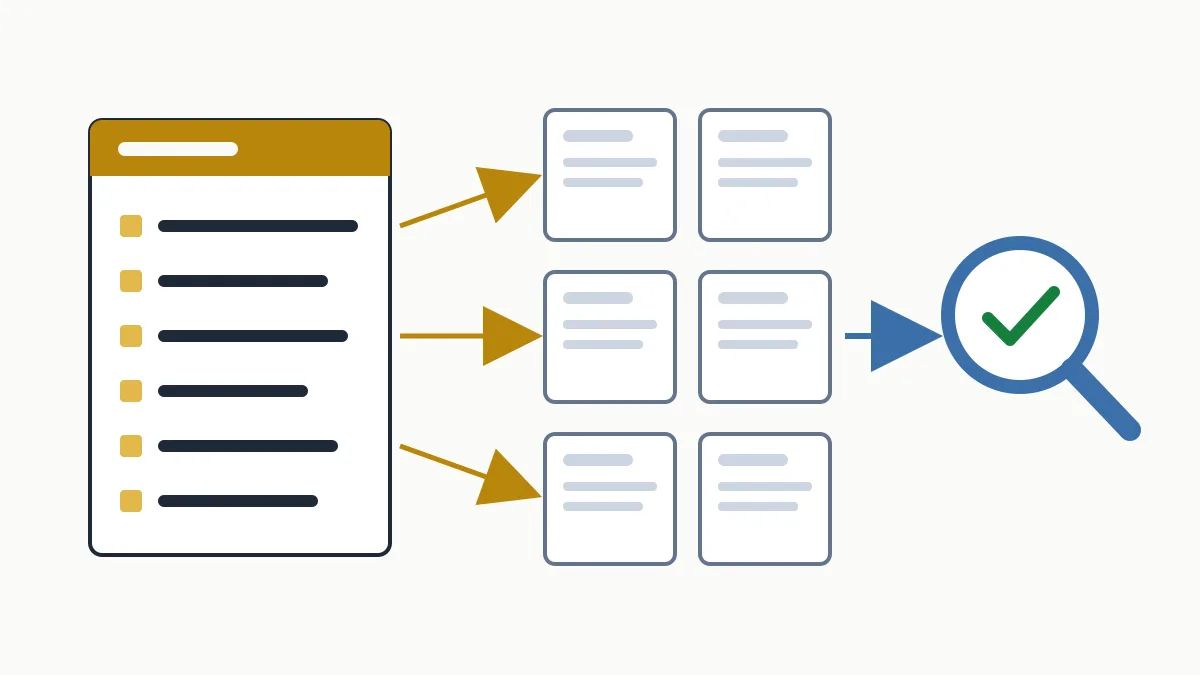
El archivo robots txt (se escribe robots.txt) es un fichero de texto plano que se coloca en la raíz de tu dominio y les dice a los rastreadores de los buscadores qué partes de la web pueden recorrer y cuáles no. Sirve para ordenar el rastreo, no para esconder páginas: una URL bloqueada puede seguir saliendo en Google si otra web la enlaza.
A una pyme casi siempre le basta con un robots.txt de cuatro líneas. El problema no suele ser que falte, sino que le sobre una: es habitual encontrar webs enteras fuera de Google por un Disallow: / que se quedó ahí después de un rediseño. Aquí tienes la sintaxis, ejemplos que puedes copiar tal cual y los errores que conviene revisar hoy.
Qué es el robots.txt y para qué sirve
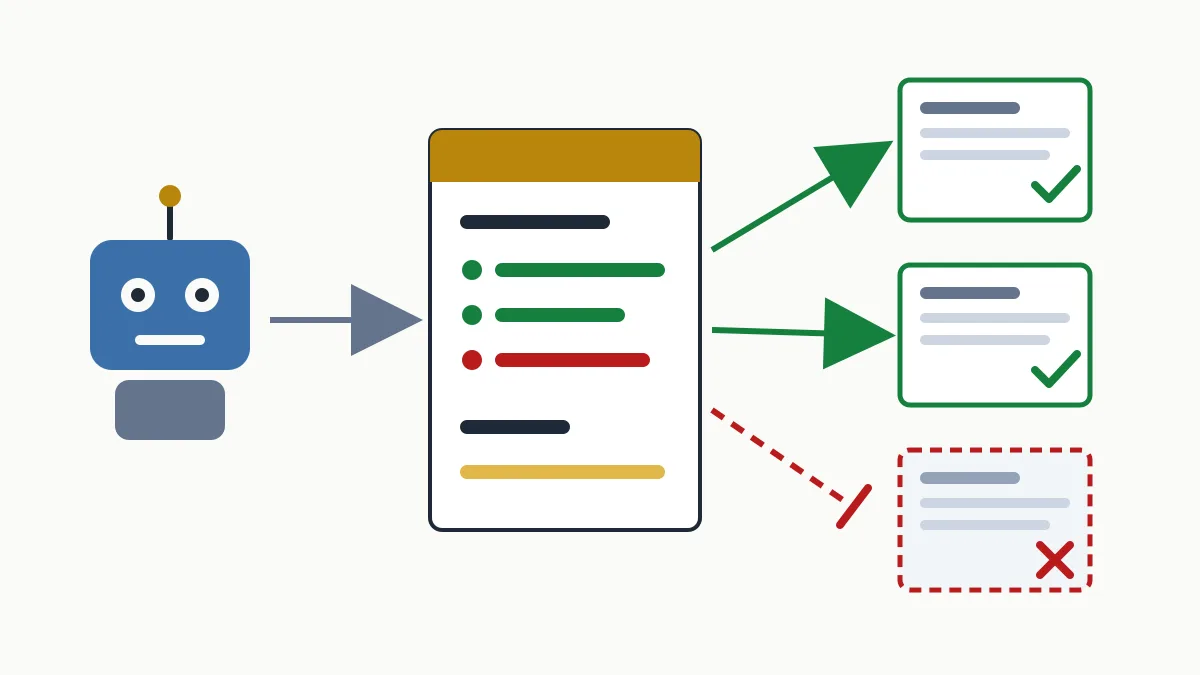
Es lo primero que pide un rastreador cuando llega a tu web: antes de visitar ninguna página, Googlebot consulta https://www.example.com/robots.txt y aplica las reglas que encuentra. Es un acuerdo de buena conducta (el «protocolo de exclusión de robots»), no una barrera técnica.
Para qué sirve de verdad:
- Evitar que los robots pierdan tiempo en zonas sin valor para la búsqueda: panel de administración, carrito, buscador interno, filtros y ordenaciones que generan miles de URL casi idénticas.
- Reducir carga en el servidor cuando un rastreador insiste demasiado en esas zonas.
- Indicar dónde está el sitemap.
Para qué no sirve:
- No saca páginas del índice de Google.
- No protege contenido privado: el archivo es público y cualquiera puede leerlo, así que listar ahí
/documentos-internos/es señalar dónde están. - No frena a los robots maliciosos, que simplemente lo ignoran.
noindex o protégela con contraseña, y no la bloquees en el robots.txt: si Google no puede entrar, tampoco puede leer el noindex.Si tu problema es el contrario (páginas que deberían salir y no salen), el recorrido completo está en el diagnóstico de por qué Google no indexa tu web.
Dónde va y cómo lo lee Google
- En la raíz del host y con ese nombre exacto, en minúsculas:
/robots.txt. Dentro de una carpeta (/blog/robots.txt) no tiene ningún efecto. - Uno por host y protocolo. El de
www.example.comno vale paratienda.example.com: cada subdominio necesita el suyo. - Texto plano en UTF-8. Nada de documentos de Word ni HTML. Google solo lee los primeros 500 KiB.
- Google lo guarda en caché, normalmente hasta 24 horas: un cambio no se aplica al instante.
- Si no existe (error 404), Google rastrea todo. No tener robots.txt no es un fallo. Lo grave es que responda con un error 5xx: Google entiende que no puede rastrear el sitio y frena.
Sintaxis del robots.txt: las cuatro directivas
El archivo se organiza en grupos. Cada grupo empieza con uno o varios User-agent y sigue con sus reglas Disallow y Allow.
| Directiva | Qué hace | Ejemplo |
|---|---|---|
User-agent | Indica a qué robot se aplica el grupo. El asterisco significa «todos». | User-agent: * |
Disallow | Ruta que ese robot no debe rastrear. | Disallow: /carrito/ |
Allow | Excepción dentro de una ruta bloqueada. | Allow: /wp-admin/admin-ajax.php |
Sitemap | URL absoluta del sitemap. Va fuera de los grupos. | Sitemap: https://www.example.com/sitemap.xml |
Reglas de lectura que evitan casi todos los sustos:
- Las rutas empiezan por
/y distinguen mayúsculas:/Fotos/y/fotos/son rutas distintas. - La coincidencia es por prefijo:
Disallow: /blogbloquea también/blog-antiguo/y/blogueros.html. Para una carpeta, termina en barra:Disallow: /blog/. *equivale a cualquier secuencia de caracteres y$marca el final de la URL.- Si un
Allowy unDisallowchocan, Google aplica la regla más específica (la ruta más larga) y, a igualdad, la menos restrictiva. - Cada robot obedece solo al grupo más específico que lo nombra. Si creas un grupo para
Googlebot, Googlebot deja de leer el de*. - Un
Disallow:vacío significa «todo permitido». Las líneas que empiezan por#son comentarios.
La directiva Sitemap es una sola línea con la dirección completa del archivo; cómo crearlo y enviarlo está explicado en el post sobre el sitemap XML. Dos directivas que verás en muchos tutoriales y que Google no admite: Crawl-delay y Noindex dentro del robots.txt.
Ejemplos de robots.txt para copiar
Cambia www.example.com por tu dominio y adapta las rutas a las de tu web.
Web corporativa: permitir todo
User-agent: *
Disallow:

Sitemap: https://www.example.com/sitemap.xml
Es lo correcto para la web de un despacho de Girona o un taller de Sabadell con treinta páginas: no hay nada que ocultar al rastreo.
WordPress
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=
Disallow: /search/

Sitemap: https://www.example.com/wp-sitemap.xml
Si no subes ningún archivo, WordPress sirve uno virtual muy parecido. No bloquees /wp-content/ ni /wp-includes/: ahí están los CSS y JavaScript que Google necesita para ver la página como la ve un visitante.
Tienda online
User-agent: *
Disallow: /carrito/
Disallow: /finalizar-compra/
Disallow: /mi-cuenta/
Disallow: /buscar/
Disallow: /*?orden=
Disallow: /*&orden=

Sitemap: https://www.example.com/sitemap.xml
Las dos líneas con asterisco cubren el parámetro de ordenación tanto si va el primero (?orden=) como si va detrás de otro (&orden=).
Bloquear un tipo de archivo o un robot concreto
User-agent: *
Disallow: /*.pdf$

User-agent: Google-Extended
Disallow: /
La primera regla impide rastrear cualquier URL que termine en .pdf. La segunda usa Google-Extended, el identificador con el que Google te deja decidir si tu contenido se usa para sus modelos de IA generativa; no afecta a tu presencia en la Búsqueda.
Bloquear todo (solo en preproducción)
# Solo para el entorno de pruebas. No subir a producción.
User-agent: *
Disallow: /
Este es el archivo que más disgustos da. Si lo usas en un entorno de pruebas, apúntalo en la lista de comprobaciones del lanzamiento; en una migración SEO es de lo primero que se revisa el día de la publicación.
Errores típicos del robots.txt
- El
Disallow: /heredado de pruebas. La web nueva sale a producción con el archivo del entorno de desarrollo y el tráfico orgánico se apaga poco a poco. - Usarlo para quitar páginas de Google. La URL bloqueada puede quedarse indexada, sin descripción, porque Google ya no puede leer su contenido ni su
noindex. - Bloquear CSS, JavaScript o imágenes. Google renderiza las páginas; si no puede cargar los recursos, evalúa una versión rota.
- Olvidar la barra final.
Disallow: /serviciose lleva por delante/servicios/entero. - Ponerlo en el sitio equivocado. En una subcarpeta, con otro nombre (
Robots.TXT) o solo en el dominio sinwwwcuando la web vive enwww. - Creer que esconde información. Las rutas que escribes ahí las lee cualquiera.
- Añadir un grupo para un robot y olvidar repetir las reglas generales. Ese robot deja de aplicar las del grupo
*.
Cómo comprobar tu robots.txt en 5 minutos
- Abre
tudominio/robots.txten el navegador y lee lo que hay. Si vesDisallow: /bajoUser-agent: *, ya has encontrado el problema. - En Google Search Console, dentro de los ajustes de la propiedad, abre el informe de robots.txt: muestra qué archivo ha leído Google, cuándo y si ha encontrado líneas que no entiende.
- Pasa por la inspección de URL una página importante (un servicio, una categoría): indica si el rastreo está permitido.
- En el informe de páginas, revisa los motivos «Bloqueada por robots.txt» e «Indexada, aunque bloqueada por robots.txt». Deben contener solo lo que tú has decidido bloquear.
Si no te manejas todavía con la herramienta, sigue la guía de cómo usar Google Search Console paso a paso. Y si prefieres que lo revisemos nosotros junto con el resto del SEO técnico, pide el análisis inicial gratuito.
Preguntas frecuentes
¿Es obligatorio tener un robots.txt?
No. Si el archivo no existe, Google rastrea toda la web con normalidad. Conviene tenerlo para indicar el sitemap y para excluir del rastreo zonas como el carrito o el buscador interno.
¿El robots.txt impide que una página salga en Google?
No. Impide que Google la rastree, pero la URL puede aparecer igualmente si otras páginas la enlazan. Para que no aparezca hay que usar noindex y dejar que Google pueda rastrearla.
¿Cuánto tarda Google en aplicar un cambio?
Google guarda una copia del archivo y la renueva normalmente en un plazo de hasta 24 horas. Desde el informe de robots.txt de Search Console puedes pedir que lo vuelva a leer antes.
¿Sirve Crawl-delay para que Google rastree más despacio?
No, Google ignora esa directiva. Otros buscadores sí la respetan, pero para Googlebot no tiene efecto.
En resumen
Un buen robots.txt es corto: permite todo lo que quieres posicionar, excluye lo que no aporta y apunta al sitemap. Revisa el tuyo ahora, sobre todo si la web se ha rediseñado hace poco. Y si quieres una segunda opinión sobre el rastreo y la indexación de tu web, el análisis inicial es gratuito y te dice por dónde empezar.