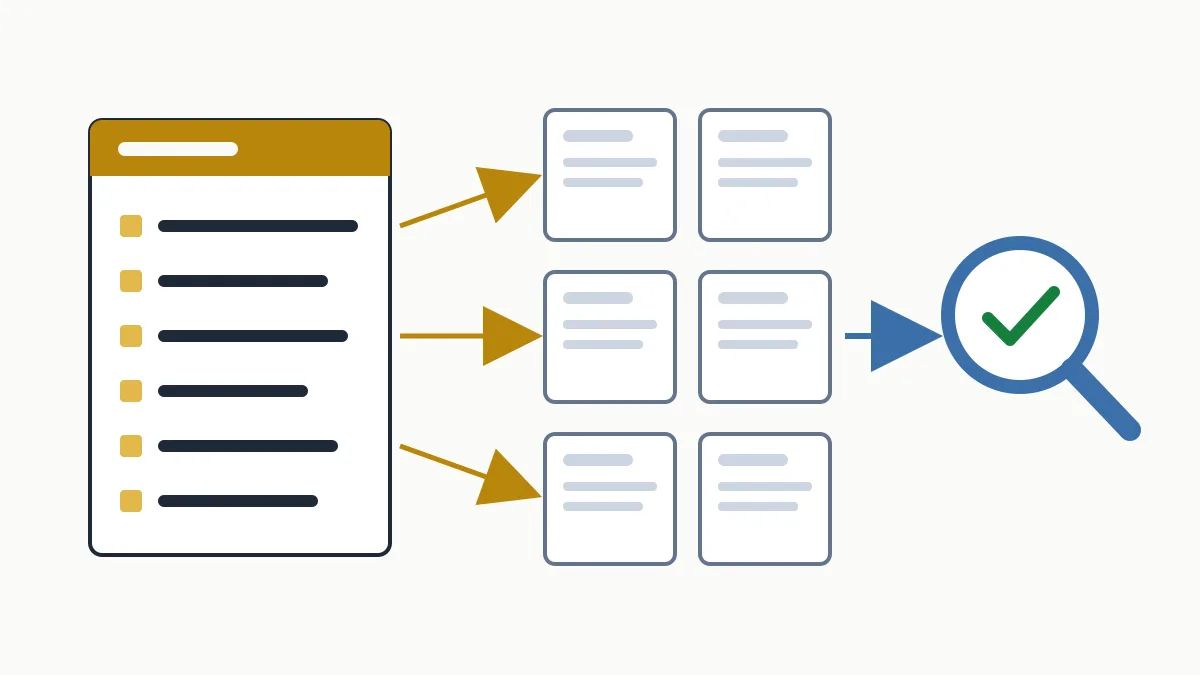
El fitxer robots txt (s'escriu robots.txt) és un fitxer de text pla que es col·loca a l'arrel del teu domini i diu als rastrejadors dels cercadors quines parts de la web poden recórrer i quines no. Serveix per ordenar el rastreig, no per amagar pàgines: una URL bloquejada pot continuar sortint a Google si una altra web l'enllaça.
A una pime gairebé sempre li n'hi ha prou amb un robots.txt de quatre línies. El problema no sol ser que falti, sinó que n'hi sobri una: és habitual trobar webs senceres fora de Google per un Disallow: / que s'hi va quedar després d'un redisseny. Aquí tens la sintaxi, exemples que pots copiar tal qual i els errors que convé revisar avui.
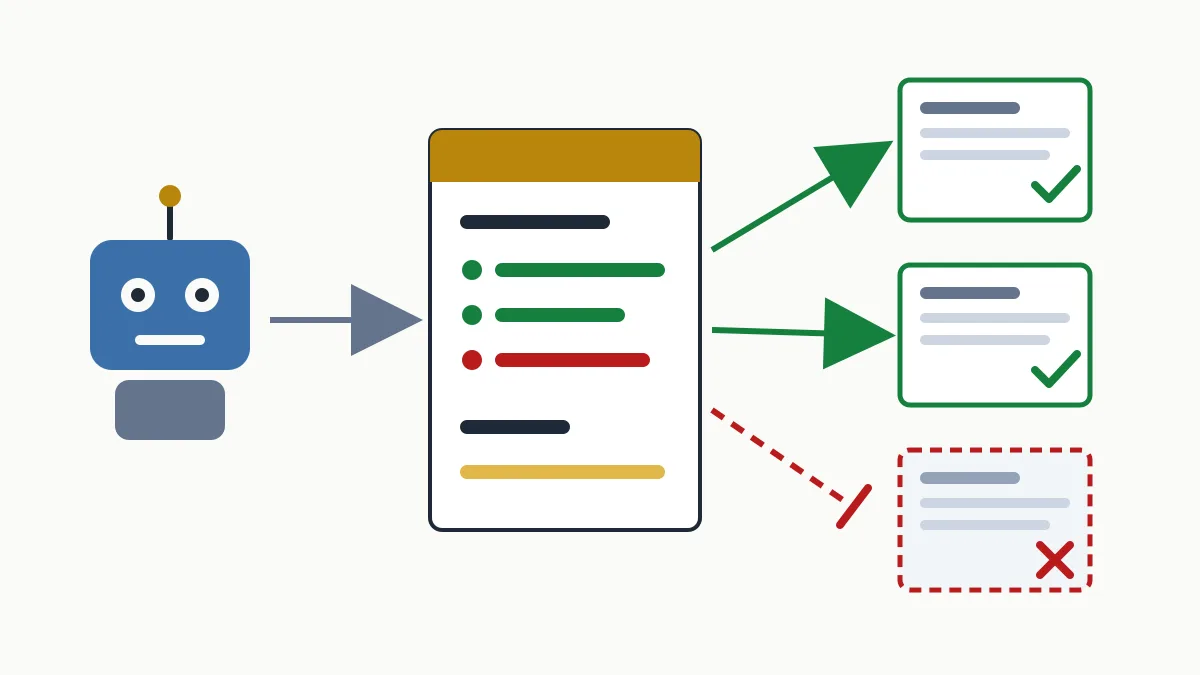
Què és el robots.txt i per a què serveix
És el primer que demana un rastrejador quan arriba a la teva web: abans de visitar cap pàgina, Googlebot consulta https://www.example.com/robots.txt i aplica les regles que hi troba. És un acord de bona conducta (el «protocol d'exclusió de robots»), no una barrera tècnica.
Per a què serveix de veritat:
- Evitar que els robots perdin temps en zones sense valor per a la cerca: tauler d'administració, cistella, cercador intern, filtres i ordenacions que generen milers d'URL gairebé idèntiques.
- Reduir càrrega al servidor quan un rastrejador insisteix massa en aquestes zones.
- Indicar on és el sitemap.
Per a què no serveix:
- No treu pàgines de l'índex de Google.
- No protegeix contingut privat: el fitxer és públic i qualsevol el pot llegir, de manera que llistar-hi
/documents-interns/és assenyalar on són. - No atura els robots maliciosos, que senzillament l'ignoren.
noindex o protegeix-la amb contrasenya, i no la bloquegis al robots.txt: si Google no hi pot entrar, tampoc pot llegir el noindex.Si el teu problema és el contrari (pàgines que haurien de sortir i no surten), el recorregut complet és al diagnòstic de per què Google no indexa la teva web.
On va i com el llegeix Google
- A l'arrel del host i amb aquest nom exacte, en minúscules:
/robots.txt. Dins d'una carpeta (/blog/robots.txt) no té cap efecte. - Un per host i protocol. El de
www.example.comno val per abotiga.example.com: cada subdomini necessita el seu. - Text pla en UTF-8. Res de documents de Word ni HTML. Google només en llegeix els primers 500 KiB.
- Google el desa a la memòria cau, normalment fins a 24 hores: un canvi no s'aplica a l'instant.
- Si no existeix (error 404), Google ho rastreja tot. No tenir robots.txt no és cap error. El que és greu és que respongui amb un error 5xx: Google entén que no pot rastrejar el lloc i frena.
Sintaxi del robots.txt: les quatre directives
El fitxer s'organitza en grups. Cada grup comença amb un o diversos User-agent i continua amb les seves regles Disallow i Allow.
| Directiva | Què fa | Exemple |
|---|---|---|
User-agent | Indica a quin robot s'aplica el grup. L'asterisc vol dir «tots». | User-agent: * |
Disallow | Ruta que aquest robot no ha de rastrejar. | Disallow: /cistella/ |
Allow | Excepció dins d'una ruta bloquejada. | Allow: /wp-admin/admin-ajax.php |
Sitemap | URL absoluta del sitemap. Va fora dels grups. | Sitemap: https://www.example.com/sitemap.xml |
Regles de lectura que eviten gairebé tots els ensurts:
- Les rutes comencen per
/i distingeixen majúscules:/Fotos/i/fotos/són rutes diferents. - La coincidència és per prefix:
Disallow: /blogbloqueja també/blog-antic/i/bloguers.html. Per a una carpeta, acaba amb barra:Disallow: /blog/. *equival a qualsevol seqüència de caràcters i$marca el final de la URL.- Si un
Allowi unDisallowxoquen, Google aplica la regla més específica (la ruta més llarga) i, en cas d'empat, la menys restrictiva. - Cada robot obeeix només el grup més específic que l'anomena. Si crees un grup per a
Googlebot, Googlebot deixa de llegir el de*. - Un
Disallow:buit vol dir «tot permès». Les línies que comencen per#són comentaris.
La directiva Sitemap és una sola línia amb l'adreça completa del fitxer; com crear-lo i enviar-lo està explicat al post sobre el sitemap XML. Dues directives que veuràs en molts tutorials i que Google no admet: Crawl-delay i Noindex dins del robots.txt.
Exemples de robots.txt per copiar
Canvia www.example.com pel teu domini i adapta les rutes a les de la teva web.
Web corporativa: permetre-ho tot
User-agent: *
Disallow:

Sitemap: https://www.example.com/sitemap.xml
És el que toca per a la web d'un despatx de Girona o d'un taller de Sabadell amb trenta pàgines: no hi ha res a amagar al rastreig.
WordPress
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=
Disallow: /search/

Sitemap: https://www.example.com/wp-sitemap.xml
Si no hi puges cap fitxer, WordPress en serveix un de virtual molt semblant. No bloquegis /wp-content/ ni /wp-includes/: hi ha els CSS i JavaScript que Google necessita per veure la pàgina com la veu un visitant.
Botiga en línia
User-agent: *
Disallow: /cistella/
Disallow: /finalitzar-compra/
Disallow: /el-meu-compte/
Disallow: /cerca/
Disallow: /*?ordre=
Disallow: /*&ordre=

Sitemap: https://www.example.com/sitemap.xml
Les dues línies amb asterisc cobreixen el paràmetre d'ordenació tant si va el primer (?ordre=) com si va darrere d'un altre (&ordre=).
Bloquejar un tipus de fitxer o un robot concret
User-agent: *
Disallow: /*.pdf$

User-agent: Google-Extended
Disallow: /
La primera regla impedeix rastrejar qualsevol URL que acabi en .pdf. La segona fa servir Google-Extended, l'identificador amb què Google et deixa decidir si el teu contingut s'utilitza per als seus models d'IA generativa; no afecta la teva presència a la Cerca.
Bloquejar-ho tot (només a preproducció)
# Només per a l'entorn de proves. No pujar a producció.
User-agent: *
Disallow: /
Aquest és el fitxer que més disgustos dona. Si el fas servir en un entorn de proves, apunta'l a la llista de comprovacions del llançament; en una migració SEO és de les primeres coses que es revisen el dia de la publicació.
Errors típics del robots.txt
- El
Disallow: /heretat de proves. La web nova surt a producció amb el fitxer de l'entorn de desenvolupament i el trànsit orgànic s'apaga a poc a poc. - Fer-lo servir per treure pàgines de Google. La URL bloquejada pot quedar indexada, sense descripció, perquè Google ja no en pot llegir el contingut ni el
noindex. - Bloquejar CSS, JavaScript o imatges. Google renderitza les pàgines; si no pot carregar els recursos, n'avalua una versió trencada.
- Oblidar la barra final.
Disallow: /serveis'emporta/serveis/sencer. - Posar-lo al lloc equivocat. En una subcarpeta, amb un altre nom (
Robots.TXT) o només al domini sensewwwquan la web viu awww. - Creure que amaga informació. Les rutes que hi escrius les llegeix qualsevol.
- Afegir un grup per a un robot i oblidar repetir-hi les regles generals. Aquell robot deixa d'aplicar les del grup
*.
Com comprovar el teu robots.txt en 5 minuts
- Obre
eltendomini/robots.txtal navegador i llegeix què hi ha. Si hi veusDisallow: /sotaUser-agent: *, ja has trobat el problema. - A Google Search Console, dins de la configuració de la propietat, obre l'informe de robots.txt: mostra quin fitxer ha llegit Google, quan i si hi ha trobat línies que no entén.
- Passa per la inspecció d'URL una pàgina important (un servei, una categoria): indica si el rastreig està permès.
- A l'informe de pàgines, revisa els motius de bloqueig per robots.txt i el d'indexada tot i estar bloquejada. Han de contenir només el que tu has decidit bloquejar.
Si encara no domines l'eina, segueix la guia de com usar Google Search Console pas a pas. I si prefereixes que ho revisem nosaltres juntament amb la resta del SEO tècnic, demana l'anàlisi inicial gratuïta.
Preguntes freqüents
És obligatori tenir un robots.txt?
No. Si el fitxer no existeix, Google rastreja tota la web amb normalitat. Convé tenir-lo per indicar el sitemap i per excloure del rastreig zones com la cistella o el cercador intern.
El robots.txt impedeix que una pàgina surti a Google?
No. Impedeix que Google la rastregi, però la URL pot aparèixer igualment si altres pàgines l'enllacen. Perquè no aparegui cal fer servir noindex i deixar que Google la pugui rastrejar.
Quant triga Google a aplicar un canvi?
Google desa una còpia del fitxer i la renova normalment en un termini de fins a 24 hores. Des de l'informe de robots.txt de Search Console pots demanar que el torni a llegir abans.
Serveix Crawl-delay perquè Google rastregi més a poc a poc?
No, Google ignora aquesta directiva. Altres cercadors sí que la respecten, però per a Googlebot no té cap efecte.
En resum
Un bon robots.txt és curt: permet tot el que vols posicionar, exclou el que no aporta i apunta al sitemap. Revisa el teu ara, sobretot si la web s'ha redissenyat fa poc. I si vols una segona opinió sobre el rastreig i la indexació de la teva web, l'anàlisi inicial és gratuïta i et diu per on començar.