El archivo llms.txt (lo verás buscado como «llms txt») es un fichero de texto en formato Markdown que se publica en la raíz de una web para ofrecer a los modelos de lenguaje y a los agentes de IA un resumen del sitio y enlaces a sus contenidos clave. Es una propuesta abierta, no un estándar: Google documenta que su buscador lo ignora y ningún gran asistente documenta que lo use para decidir qué webs cita.
Dicho esto, crearlo es barato y no hace daño. Lo que sale caro es creer que arregla algo que no arregla. Aquí tienes el formato exacto según la propuesta original, un ejemplo adaptado a una pyme y la separación que casi ninguna guía hace: qué dice la propuesta y qué está confirmado por los proveedores.
| Qué es | Un fichero Markdown con un resumen de la web y enlaces seleccionados |
|---|---|
| Dónde va | En la raíz (/llms.txt) o en una subruta (/docs/llms.txt) |
| Estatus | Propuesta abierta (versión 2, agosto de 2026). No es un estándar |
| Google Search | Documenta que no lo usa: ni ayuda ni perjudica |
| ¿Bloquea robots? | No. Eso es trabajo del robots.txt |
Qué es el llms.txt y de dónde sale
La propuesta la publicó Jeremy Howard en septiembre de 2024 en llmstxt.org y se revisó en agosto de 2026 (versión 2). Parte de un problema real: las páginas web están hechas para personas. El HTML envuelve la información en menús, banners y JavaScript, y un modelo que entra para responder una pregunta tiene que separar el grano de la paja con un espacio de contexto limitado.
La solución que plantea es un fichero corto, escrito en Markdown, que diga «esto somos y aquí tienes lo que importa», con enlaces a versiones limpias de las páginas. Según el texto, está pensado para consultarse bajo demanda, cuando un agente necesita información mientras ayuda a un usuario, más que para entrenar modelos. Donde más se usa, dice el propio autor, es en documentación de software.
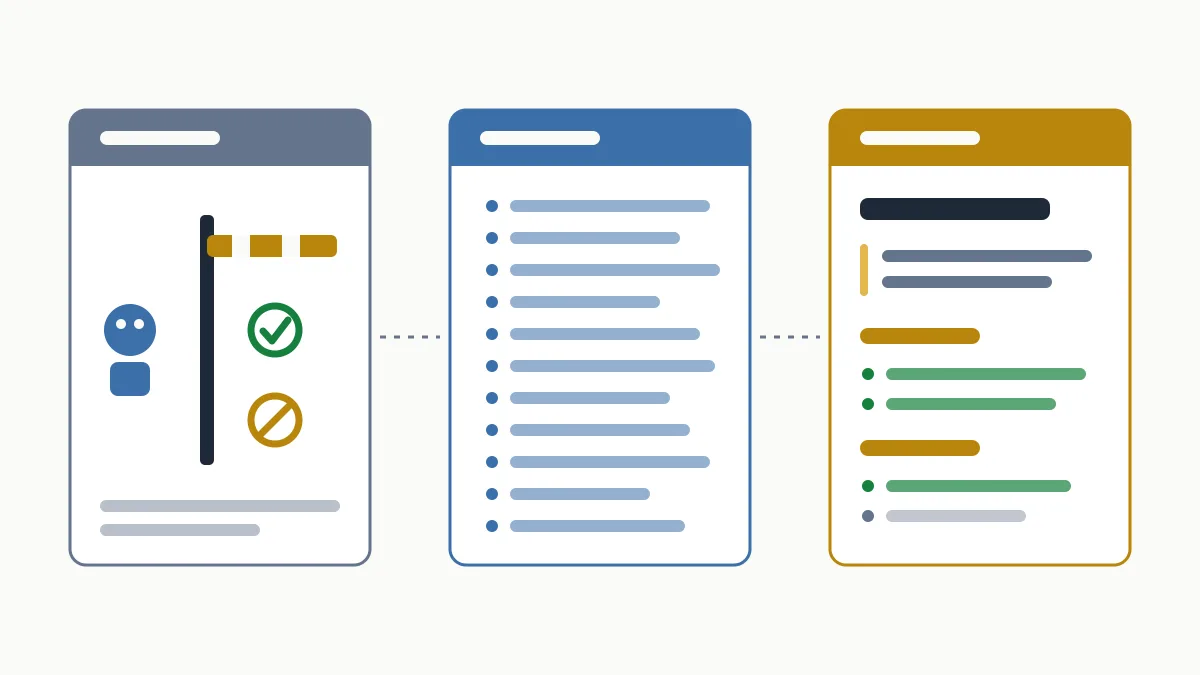
Formato del fichero llms.txt y ejemplo
El formato es estricto en el orden, aunque sea Markdown. Un fichero que sigue la propuesta contiene, por este orden:
- Un título H1 con el nombre del proyecto o de la web. Es la única parte obligatoria.
- Una cita (línea que empieza por
>) con un resumen breve que dé el contexto para entender el resto. - Texto libre opcional (párrafos o listas, sin encabezados) con detalles e indicaciones de interpretación.
- Secciones H2 con listas de enlaces. Cada elemento es un enlace Markdown
[nombre](url)y, si quieres, dos puntos y una nota.
Una sección llamada Optional se usa, por convención, para los enlaces secundarios que un agente puede saltarse si necesita un contexto más corto. Así quedaría para una gestoría ficticia:
# Gestoría Example

> Gestoría en Sabadell para autónomos y pymes: contabilidad, impuestos y nóminas. Atención en catalán y castellano.

Datos útiles: solo trabajamos con empresas y autónomos de Cataluña. Las tarifas publicadas no incluyen el IVA.

## Servicios

- [Contabilidad para autónomos](https://www.example.com/servicios/contabilidad-autonomos.md): qué incluye y a quién va dirigido
- [Nóminas y Seguridad Social](https://www.example.com/servicios/nominas.md): alcance del servicio y plazos

## Empresa

- [Tarifas](https://www.example.com/tarifas.md): precios por plan
- [Contacto y horario](https://www.example.com/contacto.md)

## Optional

- [Blog](https://www.example.com/blog/index.md): artículos sobre fiscalidad
Tres detalles de la versión actual que muchas guías todavía no recogen:
- El fichero puede vivir en una subruta y cubre las URL que cuelgan de esa ruta. Si hay más de uno, se aplica el más específico.
- La propuesta recomienda ofrecer una versión Markdown de cada página en la misma URL, añadiendo
.md(pagina.html.md) o sustituyendo la extensión (pagina.md). Los enlaces del llms.txt deberían apuntar a esas versiones limpias. - Para facilitar el descubrimiento sugiere relaciones de enlace estándar:
rel="alternate" type="text/markdown"hacia la versión Markdown yrel="describedby"hacia el llms.txt que cubre la página.
El llms-full.txt que mencionan muchos tutoriales no aparece en el texto de la propuesta: es una práctica de algunas herramientas, no una parte del formato.
Diferencias entre llms.txt, robots.txt y el sitemap XML
Los tres viven en la raíz y tienen nombre fijo, pero hacen trabajos distintos y ninguno sustituye a otro.
| robots.txt | Sitemap XML | llms.txt | |
|---|---|---|---|
| Para qué sirve | Decir a los rastreadores qué pueden recorrer | Listar las URL que quieres que se descubran | Resumir la web y apuntar al contenido clave |
| Formato | Directivas de texto plano | XML | Markdown con orden fijo |
| Alcance | Todo el dominio | Todas las páginas indexables | Una selección hecha a mano |
| Quién documenta que lo usa | Google y los rastreadores de OpenAI, Anthropic y Perplexity | Google y otros buscadores | Ningún buscador ni asistente, para su ranking o sus citas |
| ¿Controla el acceso? | Sí (es una petición, no una barrera) | No | No |
La propia propuesta lo dice: el robots.txt indica qué acceso se considera aceptable; el llms.txt aporta contexto sobre el contenido permitido. Y un sitemap no lo sustituye porque lista todas las páginas, no versiones legibles para un modelo ni una selección que quepa en un contexto. Si necesitas el detalle de cada uno, lo tienes en las guías del robots.txt y del sitemap XML.
Quién lee el llms.txt: qué está confirmado y qué no
Esta es la parte delicada. Hemos revisado la documentación pública de los proveedores el 9 de octubre de 2026 y esto es lo que hay.
Confirmado por el propio proveedor
- Google Search no lo usa. Su guía de optimización para funciones de IA generativa lo incluye en la lista de cosas que puedes ignorar: no hace falta crear ficheros legibles por máquinas ni Markdown para salir en el buscador o en sus funciones de IA, y tener uno «ni perjudica ni ayuda» a la visibilidad. Añade que Google puede rastrear e indexar el fichero como cualquier otro, sin ningún trato especial.
- Lighthouse, la herramienta de auditoría de Chrome, tiene una comprobación de llms.txt dentro de sus auditorías de navegación con agentes. Si el fichero no existe la marca como «no aplicable» porque, dice, ofrecerlo es opcional; solo falla si el servidor devuelve un error. Es una revisión técnica, no una señal de posicionamiento.
- OpenAI, Anthropic y Perplexity documentan sus rastreadores y cómo controlarlos con robots.txt. En esas páginas no dicen que sus robots lean el llms.txt de las webs que visitan.
- Esas mismas empresas publican un llms.txt para su propia documentación para desarrolladores. Publicar uno no equivale a consumir el de los demás.
No confirmado
- Que ChatGPT, Claude, Perplexity o Gemini consulten tu llms.txt antes de responder.
- Que tenerlo aumente las probabilidades de que te citen.
- Que influya en ningún ranking.
La propuesta afirma que los agentes de programación lo usan de forma habitual para encontrar documentación. Es una afirmación de su autor y encaja con el uso en documentación técnica, pero no es un compromiso de ningún buscador.
¿Debe tener un llms.txt una pyme?
Mi criterio, sin dramatismos:
- Tiene sentido si vendes software, tienes una API o documentación técnica que los desarrolladores consultan con asistentes de código. Es el caso de uso que la propuesta describe como principal.
- Puedes hacerlo sin remordimientos si tu gestor de contenidos lo genera solo y lo mantiene al día. Coste casi cero.
- No es prioritario para un restaurante de Gràcia, una clínica de Tarragona o un despacho de Girona. Antes hay trabajo que sí cuenta.
Ese trabajo es el de siempre: que las páginas se puedan rastrear e indexar, que respondan bien a preguntas concretas y que la web sea una fuente fiable. Google documenta que, para salir como enlace de apoyo en sus respuestas de IA, una página tiene que estar indexada y poder mostrarse con fragmento; nada más. Lo desarrollamos en las guías de GEO, de AEO y SEO y de SEO para IA, y es lo que revisamos en el servicio de SEO técnico.
Si decides crearlo, hazlo en cuatro pasos: elige entre cinco y quince páginas que expliquen el negocio, escribe el resumen en dos frases, enlaza versiones limpias y pruébalo. La propia propuesta sugiere la prueba: dale solo el fichero a un asistente y hazle preguntas sobre tu empresa.
Errores habituales con el llms.txt
- Usarlo para bloquear. No es un robots.txt y no admite directivas de acceso.
- Volcar todas las URL. Para eso ya tienes el sitemap. El valor está en la selección.
- Dejarlo envejecer. Un fichero con precios o servicios antiguos contradice a la web, y una fuente que se contradice es peor que ninguna fuente.
- Enlazar páginas que no quieres públicas. El fichero es público y Google puede indexarlo.
- Pagarlo como si fuera posicionamiento. Si alguien te lo vende como garantía de salir en ChatGPT, pídele dónde lo documenta el proveedor.
Si quieres saber qué frena de verdad la visibilidad de tu web, en buscadores y en asistentes, pídenos el análisis inicial gratuito: revisamos rastreo, indexación y contenido, y te decimos por dónde empezar.
Preguntas frecuentes
¿El llms.txt mejora el posicionamiento en Google?
No. Google documenta que su buscador no usa estos ficheros y que tener uno ni ayuda ni perjudica a la visibilidad ni a los rankings.
¿Es obligatorio tener un llms.txt?
No. Es una propuesta voluntaria. Incluso la auditoría de Lighthouse lo trata como opcional y no penaliza que no exista.
¿Dónde se coloca el fichero?
En la raíz del dominio, como https://www.example.com/llms.txt, o en una subruta si solo quieres cubrir una parte de la web, por ejemplo la documentación.
¿Sirve para impedir que la IA use mi contenido?
No. Para limitar el acceso de los rastreadores de IA se usa el robots.txt con el nombre de cada robot, que es el mecanismo que documentan los proveedores.
¿Es lo mismo llms.txt que llm.txt?
El nombre que define la propuesta es llms.txt, en plural. «llm.txt» es una errata frecuente; un fichero con ese nombre no sigue la especificación.