El fitxer llms.txt (el veuràs cercat com a «llms txt») és un arxiu de text en format Markdown que es publica a l'arrel d'un web per oferir als models de llenguatge i als agents d'IA un resum del lloc i enllaços als seus continguts clau. És una proposta oberta, no un estàndard: Google documenta que el seu cercador l'ignora i cap gran assistent documenta que el faci servir per decidir quins webs cita.
Dit això, crear-lo és barat i no fa mal. El que surt car és creure que arregla alguna cosa que no arregla. Aquí tens el format exacte segons la proposta original, un exemple adaptat a una pime i la separació que gairebé cap guia fa: què diu la proposta i què està confirmat pels proveïdors.
| Què és | Un fitxer Markdown amb un resum del web i enllaços seleccionats |
|---|---|
| On va | A l'arrel (/llms.txt) o en una subruta (/docs/llms.txt) |
| Estatus | Proposta oberta (versió 2, agost de 2026). No és un estàndard |
| Google Search | Documenta que no el fa servir: ni ajuda ni perjudica |
| Bloqueja robots? | No. Això és feina del robots.txt |
Què és el llms.txt i d'on surt
La proposta la va publicar Jeremy Howard el setembre de 2024 a llmstxt.org i es va revisar l'agost de 2026 (versió 2). Parteix d'un problema real: les pàgines web estan fetes per a persones. L'HTML embolcalla la informació amb menús, bàners i JavaScript, i un model que hi entra per respondre una pregunta ha de separar el gra de la palla amb un espai de context limitat.
La solució que planteja és un fitxer curt, escrit en Markdown, que digui «això som i aquí tens el que importa», amb enllaços a versions netes de les pàgines. Segons el text, està pensat per consultar-se sota demanda, quan un agent necessita informació mentre ajuda un usuari, més que per entrenar models. On més es fa servir, diu el mateix autor, és en documentació de programari.
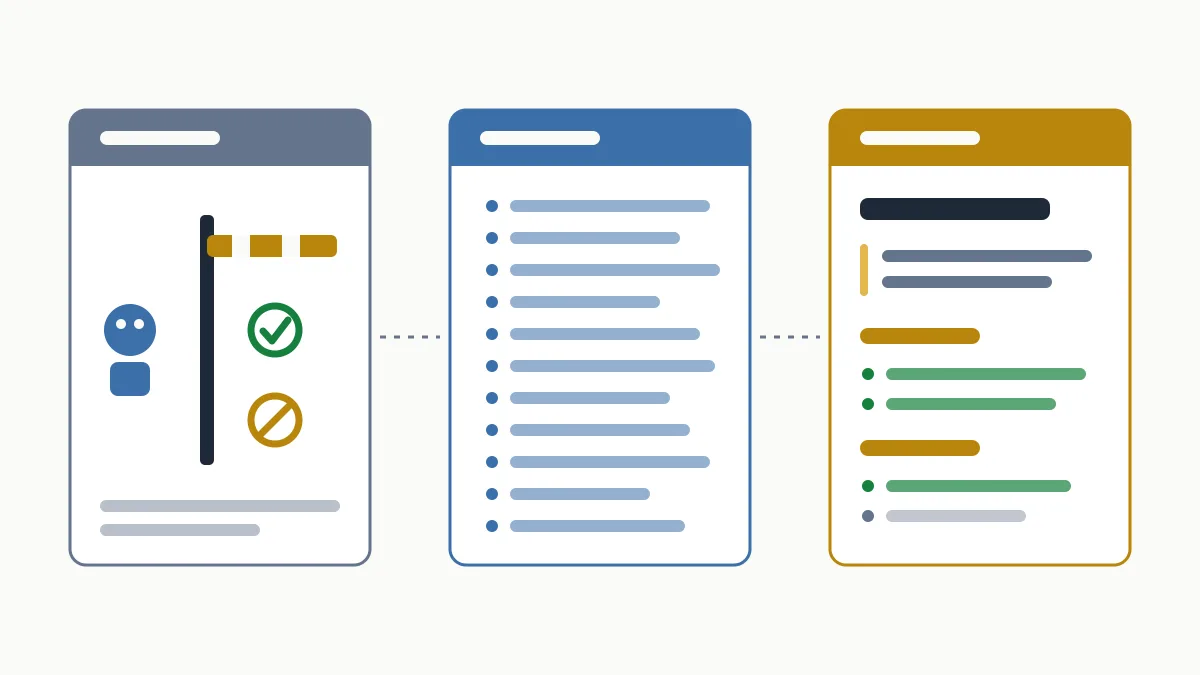
Format del fitxer llms.txt i exemple
El format és estricte en l'ordre, tot i ser Markdown. Un fitxer que segueix la proposta conté, per aquest ordre:
- Un títol H1 amb el nom del projecte o del web. És l'única part obligatòria.
- Una cita (línia que comença amb
>) amb un resum breu que doni el context per entendre la resta. - Text lliure opcional (paràgrafs o llistes, sense encapçalaments) amb detalls i indicacions d'interpretació.
- Seccions H2 amb llistes d'enllaços. Cada element és un enllaç Markdown
[nom](url)i, si vols, dos punts i una nota.
Una secció anomenada Optional s'utilitza, per convenció, per als enllaços secundaris que un agent pot saltar-se si necessita un context més curt. Així quedaria per a una gestoria fictícia:
# Gestoria Example

> Gestoria a Sabadell per a autònoms i pimes: comptabilitat, impostos i nòmines. Atenció en català i castellà.

Dades útils: només treballem amb empreses i autònoms de Catalunya. Les tarifes publicades no inclouen l'IVA.

## Serveis

- [Comptabilitat per a autònoms](https://www.example.com/serveis/comptabilitat-autonoms.md): què inclou i a qui va adreçat
- [Nòmines i Seguretat Social](https://www.example.com/serveis/nomines.md): abast del servei i terminis

## Empresa

- [Tarifes](https://www.example.com/tarifes.md): preus per pla
- [Contacte i horari](https://www.example.com/contacte.md)

## Optional

- [Blog](https://www.example.com/blog/index.md): articles sobre fiscalitat
Tres detalls de la versió actual que moltes guies encara no recullen:
- El fitxer pot viure en una subruta i cobreix les URL que pengen d'aquesta ruta. Si n'hi ha més d'un, s'aplica el més específic.
- La proposta recomana oferir una versió Markdown de cada pàgina a la mateixa URL, afegint
.md(pagina.html.md) o substituint l'extensió (pagina.md). Els enllaços del llms.txt haurien d'apuntar a aquestes versions netes. - Per facilitar el descobriment suggereix relacions d'enllaç estàndard:
rel="alternate" type="text/markdown"cap a la versió Markdown irel="describedby"cap al llms.txt que cobreix la pàgina.
El llms-full.txt que esmenten molts tutorials no apareix al text de la proposta: és una pràctica d'algunes eines, no una part del format.
Diferències entre llms.txt, robots.txt i el sitemap XML
Els tres viuen a l'arrel i tenen nom fix, però fan feines diferents i cap substitueix l'altre.
| robots.txt | Sitemap XML | llms.txt | |
|---|---|---|---|
| Per a què serveix | Dir als rastrejadors què poden recórrer | Llistar les URL que vols que es descobreixin | Resumir el web i apuntar al contingut clau |
| Format | Directives de text pla | XML | Markdown amb ordre fix |
| Abast | Tot el domini | Totes les pàgines indexables | Una selecció feta a mà |
| Qui documenta que el fa servir | Google i els rastrejadors d'OpenAI, Anthropic i Perplexity | Google i altres cercadors | Cap cercador ni assistent, per al seu rànquing o les seves cites |
| Controla l'accés? | Sí (és una petició, no una barrera) | No | No |
La mateixa proposta ho diu: el robots.txt indica quin accés es considera acceptable; el llms.txt aporta context sobre el contingut permès. I un sitemap no el substitueix perquè llista totes les pàgines, no versions llegibles per a un model ni una selecció que càpiga en un context. Si necessites el detall de cadascun, el tens a les guies del robots.txt i del sitemap XML.
Qui llegeix el llms.txt: què està confirmat i què no
Aquesta és la part delicada. Hem revisat la documentació pública dels proveïdors el 9 d'octubre de 2026 i això és el que hi ha.
Confirmat pel mateix proveïdor
- Google Search no el fa servir. La seva guia d'optimització per a funcions d'IA generativa l'inclou a la llista de coses que pots ignorar: no cal crear fitxers llegibles per màquines ni Markdown per sortir al cercador o a les seves funcions d'IA, i tenir-ne un «ni perjudica ni ajuda» la visibilitat. Afegeix que Google pot rastrejar i indexar el fitxer com qualsevol altre, sense cap tracte especial.
- Lighthouse, l'eina d'auditoria de Chrome, té una comprovació de llms.txt dins de les auditories de navegació amb agents. Si el fitxer no existeix, la marca com a «no aplicable» perquè, diu, oferir-lo és opcional; només falla si el servidor retorna un error. És una revisió tècnica, no un senyal de posicionament.
- OpenAI, Anthropic i Perplexity documenten els seus rastrejadors i com controlar-los amb robots.txt. En aquestes pàgines no diuen que els seus robots llegeixin el llms.txt dels webs que visiten.
- Aquestes mateixes empreses publiquen un llms.txt per a la seva pròpia documentació per a desenvolupadors. Publicar-ne un no equival a consumir el dels altres.
No confirmat
- Que ChatGPT, Claude, Perplexity o Gemini consultin el teu llms.txt abans de respondre.
- Que tenir-lo augmenti les probabilitats que et citin.
- Que influeixi en cap rànquing.
La proposta afirma que els agents de programació el fan servir de manera habitual per trobar documentació. És una afirmació del seu autor i encaixa amb l'ús en documentació tècnica, però no és un compromís de cap cercador.
L'ha de tenir una pime?
El meu criteri, sense dramatismes:
- Té sentit si vens programari, tens una API o documentació tècnica que els desenvolupadors consulten amb assistents de codi. És el cas d'ús que la proposta descriu com a principal.
- Pots fer-ho sense remordiments si el teu gestor de continguts el genera sol i el manté al dia. Cost gairebé zero.
- No és prioritari per a un restaurant de Gràcia, una clínica de Tarragona o un despatx de Girona. Abans hi ha feina que sí que compta.
Aquesta feina és la de sempre: que les pàgines es puguin rastrejar i indexar, que responguin bé a preguntes concretes i que el web sigui una font fiable. Google documenta que, per sortir com a enllaç de suport a les seves respostes d'IA, una pàgina ha d'estar indexada i poder mostrar-se amb fragment; res més. Ho desenvolupem a les guies de GEO, d'AEO i SEO i de SEO per a IA, i és el que revisem al servei de SEO tècnic.
Si decideixes crear-lo, fes-ho en quatre passos: tria entre cinc i quinze pàgines que expliquin el negoci, escriu el resum en dues frases, enllaça versions netes i prova'l. La mateixa proposta suggereix la prova: dona només el fitxer a un assistent i fes-li preguntes sobre la teva empresa.
Errors habituals amb el llms.txt
- Fer-lo servir per bloquejar. No és un robots.txt i no admet directives d'accés.
- Bolcar-hi totes les URL. Per a això ja tens el sitemap. El valor és la selecció.
- Deixar-lo envellir. Un fitxer amb preus o serveis antics contradiu el web, i una font que es contradiu és pitjor que cap font.
- Enllaçar pàgines que no vols públiques. El fitxer és públic i Google el pot indexar.
- Pagar-lo com si fos posicionament. Si algú te'l ven com a garantia de sortir a ChatGPT, demana-li on ho documenta el proveïdor.
Si vols saber què frena de veritat la visibilitat del teu web, a cercadors i a assistents, demana'ns l'anàlisi inicial gratuïta: revisem rastreig, indexació i contingut, i et diem per on començar.
Preguntes freqüents
El llms.txt millora el posicionament a Google?
No. Google documenta que el seu cercador no fa servir aquests fitxers i que tenir-ne un ni ajuda ni perjudica la visibilitat ni els rànquings.
És obligatori tenir un llms.txt?
No. És una proposta voluntària. Fins i tot l'auditoria de Lighthouse el tracta com a opcional i no penalitza que no existeixi.
On es col·loca el fitxer?
A l'arrel del domini, com a https://www.example.com/llms.txt, o en una subruta si només vols cobrir una part del web, per exemple la documentació.
Serveix per impedir que la IA faci servir el meu contingut?
No. Per limitar l'accés dels rastrejadors d'IA s'utilitza el robots.txt amb el nom de cada robot, que és el mecanisme que documenten els proveïdors.
És el mateix llms.txt que llm.txt?
El nom que defineix la proposta és llms.txt, en plural. «llm.txt» és una errada freqüent; un fitxer amb aquest nom no segueix l'especificació.